Ансамбль агентов, когда второй прогон окупается
Хотел сравнить Fable и Opus, а наткнулся на ансамбль. Одна задача, два-четыре независимых агента и сведение, что/как/почему ниже
Самое полезное
- Главная находка последних недель по эффективности оказалась не про модель и не про effort, а про второго агента на ту же задачу
- На моих задачах два Opus 5.5 high параллельно находят больше одного Opus 5.5 xhigh и заканчивают быстрее, хоть и стоят чутка дороже
- На десяти моих прогонах второй прогон ни разу не оказался пустым, чаще всего он ловил то, что первый пропустил на дорогой задаче
Как я на это наткнулся
Пару недель назад, работая, не зная горя после выхода Opus 5.5, решил внезапно сравнить его на одной и той же задаче с Fable 5.1, запустил четыре прогона с одинаковыми вводными, по два на каждую модель, ведь самый минимум чтобы избежать шума это хотя бы 2-3 прогона на одной задаче делать. Запускал 2х Opus 5.5 xhigh и 2х Fable 5.1 high, всех параллельно
Результат моделей в итоге почти не отличался, но! Оказалось, что два прогона одной и той же модели находят заметно разное, это подтолкнуло меня экспериментировать с этим и время от времени запускать на задачу 2-4 независимых агента на Opus 5.5 high (а зачем же фейбл 5.1, когда есть опус? 😄)
 Открыть оригинал
Оказалось, так делают и другие
Порадовавшись своему "открытию", я закономерно подумал: "Я не мог быть первым, 100% кто-то уже что-то писал об этом"
Как выявилось, это даже проверено на людях в 90-х, а с моделями это давно уже есть и в статьях, и в инструментах, но самому додуматься без практики, как мне кажется, невозможно
Все кажется очевидным, когда ты узнаешь об этом
Ссылки на смежные материалы будут в конце
Немного чисел
В один из дней я проводил эвал моделей на 24 своих задачах не про код, по два прогона на каждую модель и задачу, и тут моя "находка" еще раз случайно подтвердилась - два опуса 5.5 high в среднем находили больше, чем один мега-думающий медленный xhigh
| Нашли по чек-листу | Цена ответа | Минут | |
|---|---|---|---|
| один Opus 5.5 high | 65% | $1,55 | 4,8 |
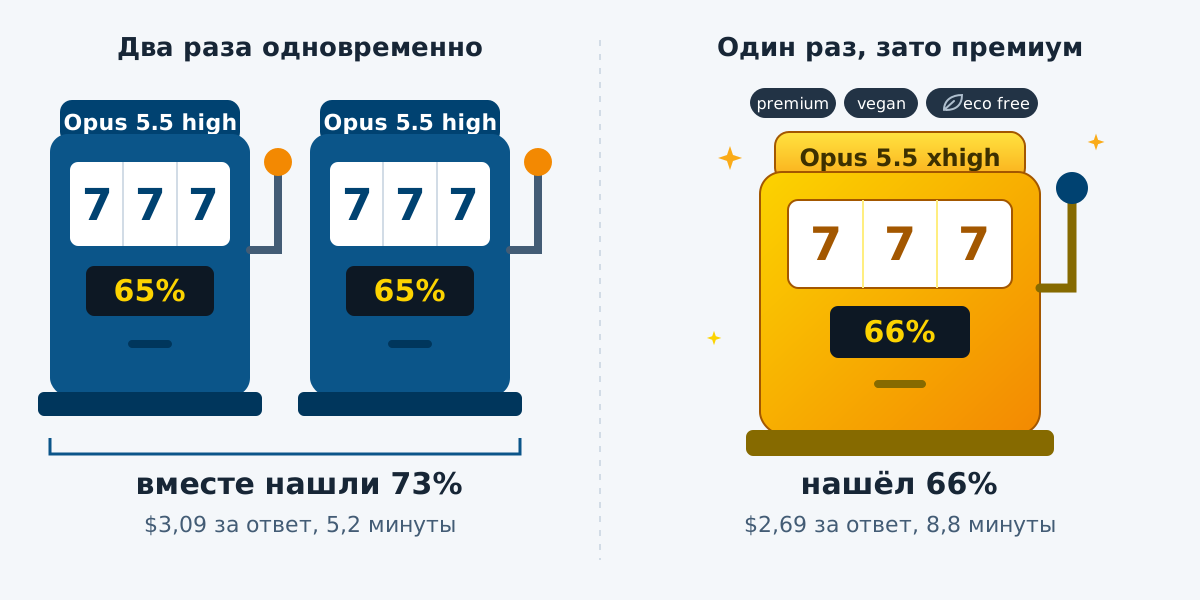
| два Opus 5.5 high параллельно | 73% | $3,09 | 5,2 |
| один Opus 5.5 xhigh | 66% | $2,69 | 8,8 |
Один xhigh находит столько же, сколько один high, а идёт почти вдвое дольше. Два high параллельно находят больше обоих, заканчивают почти так же быстро, как один high, и стоят примерно на 15% дороже одного xhigh. Выигрыш в основном от того, что один из двух прогонов оказывается сильнее, а какой именно, заранее не угадаешь, но ведь это наша любимая часть в агентской разработке, не так ли?
Где использовать
В пример приведу несколько прошлых прогонов "ансамбля"
- Дыры в коде дайджеста. Два агента искали дыры в коде бота, который шлёт мне дайджест новостей в Telegram. Каждый нашёл по 18, но разных, вместе 25 (+40% находок!). И только один заметил, что при медленном отклике Telegram выпуск приходит дважды, а спам я не одобряю
- План покупок для переезда ПК. Два агента нашли 16 и 20 замечаний, почти не пересеклись, вместе вышло.. 32 замечания (как минимум +60% находок). Только один заметил, что я смотрел бы в чёрный экран, если бы не удалил до переезда виртуальный монитор и не переключил стрим на новую видеокарту
- Ретро длинных сессий. Дважды я просил главную сессию разобрать, что пошло не так, и параллельно давал её лог свежему агенту. Оба раза самую дорогую проблему нашёл свежий
- Варианты анимации для клиента. Тут нужен был не правильный ответ, а разные идеи, и четыре агента придумали по 8 вариантов, разных среди них оказалось 13. Клиенту больше всего зашла та идея, которой у двух агентов из четырёх не было вовсе (слоты наше всё)
Естественно ансамбль не серебряная пуля. Два агента писали ТЗ для программиста, и оба ошиблись в одном и том же месте, потому что читали одни и те же устаревшие данные. Если на входе у всех ошибка, сколько агентов ни запускай, ошибутся все одинаково
Когда использовать
Честно, пока по ощущениям, а ощущения сформулировать могу так:
- Промах дорогой, и потом его никто не заметит
- Текст уходит другому человеку, и ошибка стоит лишнего круга переписки
- Нужны разные варианты, а не один правильный ответ
- Нужен разный взгляд со стороны
А почему два, а не три или больше?
И это правильный вопрос! Ведь всем известно, что 99% разработчиков перестают крутить ЛЛМку перед самым лучшим решением!
А если серьёзно, то для себя я остановился на 2-4 независимых агентах, больше четырёх не пробовал, но уже третий и четвёртый добавляют заметно меньше, чем второй, и чаще всего двух хватает с головой, а 3-4 беру просто для спокойствия души
Обычно главная сессия-босс сама в ансамбле не участвует, она только собирает ответы агентов в один и перепроверяет то, что нашёл только кто-то один
Иногда я всё же запускаю ансамбль вместе с главным агентом. Интересно посмотреть, что найдут агенты со свежей головой и что пропустит сессия со всем контекстом
Не запускаю на мелочах, которые сам замечу и поправлю за минуту, и там, где важен только мой вкус
Интересные и не очень материалы
- Сам скилл, можно поставить себе: github.com/Sundwell/claude-skills (откроется в новой вкладке)
- Девять независимых команд проверяли одни и те же требования. Одна команда находила в среднем 35% ошибок, все девять вместе 78%. N-fold inspection, ACM TOSEM 1992 (откроется в новой вкладке)
- На живом проекте два рецензента нашли столько же, сколько четыре. Porter et al., IEEE TSE 1997 (откроется в новой вкладке)
- Модель отвечает несколько раз, и берётся самый частый ответ. На школьных задачах по математике это дало +17,9%. Self-consistency, Wang et al., ICLR 2023 (откроется в новой вкладке)
- Агентам не обязательно спорить друг с другом. Простое голосование работает не хуже дебатов. Debate or Vote, NeurIPS 2025 (откроется в новой вкладке)
- У одного практика 45% из 285 багов нашёл ровно один ИИ-рецензент из нескольких. Alexander Murmann, AI reviewers (откроется в новой вкладке)
- Code Review в Claude Code запускает несколько агентов параллельно и отдельно голосует по каждой находке. Anthropic, Solving code review (откроется в новой вкладке)
- В Cursor есть команда /best-of-n, в Codex от одной до четырёх попыток на задачу. Та же задача запускается несколько раз, а лучший вариант выбирает человек. Cursor 3.0 (откроется в новой вкладке), Codex CLI (откроется в новой вкладке)